


Чем ценнее данные компании, тем меньше из них пользы: почему защита и аналитика мешают друг другу

Когда компании начали внедрять корпоративный ИИ, выяснилось, что многие не знают, какие данные в них хранятся, кто за них отвечает и куда их копируют. Ранее из-за этого тормозила отчетность и дорожали интеграции. Теперь одна ошибка может открыть модели чужих документов или отправить конфиденциальную информацию во внешний сервис.
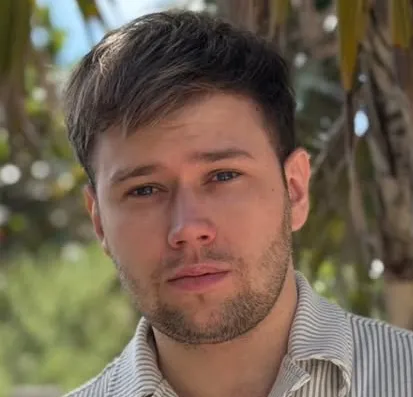
Олег Бондарчук более 18 лет работает с корпоративной инфраструктурой и облачной безопасностью, а сейчас проектирует среду Microsoft Azure для крупной международной перестраховочной компании. Он Senior Member IEEE, оценивает заявки других инженеров на этот статус, технические публикации и работы участников международных технологических конкурсов, а также пишет научные статьи о кибербезопасности и искусственном интеллекте. В интервью он рассказывает, как сделать самые чувствительные данные компании пригодными для аналитики и ИИ без новых исключений из правил безопасности.
Почему самые ценные данные компании так часто лежат без дела?
Ибо их закрывают, но не описывают. Клиентскую историю, страховые дела или медицинские документы изолируют в отдельных системах, и на этом работа с ними заканчивается: нет каталога, нет владельца, отвечающего за качество, нет понятного способа получить доступ. Аналитик, которому нужны эти данные, месяцами ждет согласований и наконец-то просит выгрузку в Excel, которую уже никто не контролирует. Выходит, что защита без нормального способа работать с данными сама толкает людей его обходить.
Итак, безопасность и аналитика действительно конфликтуют?
Конфликтируют, когда их проектируют разные команды в разное время. Обычно разработчики строят систему, а перед запуском приходит служба безопасности со списком требований. Часть выполняют, на остальное оформляют ручные исключения, и каждый последующий проект повторяет тот же путь. Если же архитектуру данных и правила доступа будут проектированы вместе, безопасность заранее определяет, кто и с какой целью может пользоваться данными, поэтому новый отчет или приложение подключается по готовым правилам.
Вы создали фреймворк, по которому команды перенесли в Azure 300 приложений и несколько landing zones для критических систем. Как безопасность, заложенная в платформу, смотрится на практике?
Landing zone проще всего представить как подготовленную площадку в облаке. Сетевые границы, учетные записи, политики доступа и журналирования там настроены еще до того, как команда принесет приложение. Для миграции такого масштаба это важно: согласовывать безопасность для каждого из 300 приложений отдельно было бы нереально. Команда получает проверенный маршрут и контрольные проверки на нем срабатывают автоматически. Тот же принцип я закладывал в автоматизацию развертывания для Azure Marketplace: когда правильный путь самый простой, обходные становятся ненужными.
Многие компании считают зашифрованные данные защищенными. Почему этого не достаточно?
Шифрование спасает, если кто-то украл диск или перехватил трафик. Однако аккаунт пользователя или сервиса с лишними правами получит данные уже расшифрованными. Поэтому более важен вопрос: кто имеет доступ и зачем. Ответ на него дают классификация данных, минимально необходимые права и управляемые идентичности вместо общих паролей. Самые чувствительные поля, например номера страхования или банковские реквизиты, я шифрую отдельно в соответствии с требованиями GDPR. Еще одно слабое место: секреты и сертификаты, по которым программы обращаются друг к другу. Я разработал платформу, которая следит за сроками их действия и заранее предупреждает ответственные команды, чтобы обновления не производились в последний момент.
В R2 Copilot вы использовали RAG, чтобы не передавать ИИ всю внутреннюю базу. Этого достаточно для конфиденциальности?
RAG работает следующим образом: документы индексируются в контролируемой среде, а модель на каждый вопрос получает всего несколько нужных фрагментов. Контекста передается меньше, и видно, откуда он взялся. Однако, если поиск не учитывает права пользователя, ассистент охотно покажет бухгалтеру документы юридического отдела. Поэтому в R2 Copilot результаты фильтруются по правам конкретного человека, источники разграничены, а каждое обращение попадает в журнал. Подобную логику мы закладывали в платформу цифровой идентичности HyperID: сервис подтверждает только тот факт, который нужен для сделки, и не получает копию всего профиля.
Один из ваших проектов касался оцифровки около 15 миллионов страниц медицинской и фармацевтической документации в Казахстане. Что он показал?
Само по себе оцифровка мало что изменяет. Если отсканировать архив и сложить файлы в хранилище без модели доступа, бумажный склад просто становится цифровым. Польза появляется, когда документы можно быстро найти, проверить и использовать в работе, и одновременно известно, кто и когда их открывал. Поэтому поиск и правила доступа в таких проектах следует продумывать одновременно с хранилищем.
Как подготовить данные к ИИ, какого бизнес еще даже не выбрал и как понять, что это удалось?
Угадывать модель не нужно. Достаточно, чтобы у каждого источника данных были владелец, классификация и контролируемый интерфейс доступа, а каждое обращение оставляло в журнале. Тогда новый ассистент получает ограниченный и документированный доступ к нужным данным. Результат виден по нескольким показателям: сколько времени занимает предоставление безопасного доступа, какая доля источников владельца, сколько ручных исключений осталось. Думаю, в ближайшие годы будут выигрывать быстро доказывающие компании, откуда их данные, насколько они качествены и можно ли их использовать. Хотя техническая доступность данных еще не дает права ими пользоваться, и этот предел инженер не может определять сам.
Читайте нас в Facebook
Сейчас читают на Информаторе